Ajustes → Rendimiento IA ayuda a elegir modelo. Compara lo que da cada uno en este trabajo concreto —leer expedientes y citar el papel— y dice si el servicio de cada proveedor está funcionando ahora.
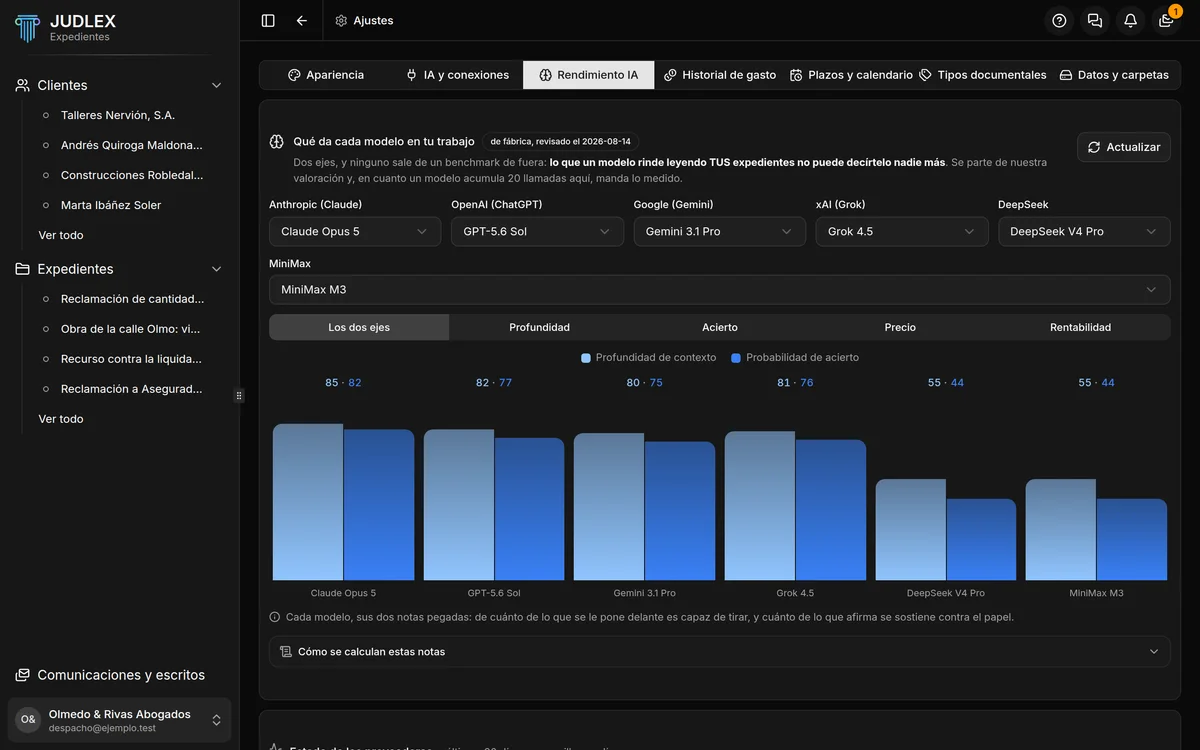
Qué da cada modelo en su trabajo
Cada modelo tiene dos notas:
Profundidad de contexto: cuánto de lo que se le pone delante es capaz de aprovechar.
Probabilidad de acierto: cuánto de lo que afirma se sostiene contra el papel.
Las notas de partida son una valoración propia de JUDLEX, no un examen público, y la etiqueta dice cuándo se revisaron. En cuanto un modelo acumula veinte llamadas en su despacho, pasa a mandar lo medido en sus propios expedientes.
Arriba se elige qué modelo de cada proveedor se compara. Las vistas cambian lo que se enseña:
Los dos ejes: las dos notas juntas.
Profundidad y Acierto: cada una por separado.
Precio: lo que cuesta cada modelo.
Rentabilidad: lo que da cada modelo por lo que cuesta.
Cómo se calculan estas notas, abajo, explica las cuentas. Actualizar vuelve a leer las medidas.
Si ya hay medidas, Borrar lo medido y empezar de cero las borra y vuelve a las notas de partida. Se hace al pulsar, sin preguntar.
Estado de los proveedores
Debajo, una fila por proveedor con una casilla por día de los últimos noventa, según la página de estado que publica cada uno: verde si todo funcionó, y en otro color los días con incidencias. Su página abre esa página de estado.
Al lado, cuánto tarda en contestar el servicio del proveedor desde su equipo. Esa prueba no usa su clave y no cuesta nada.
La misma información, en pequeño, está en la barrita de color del pie del panel de consulta.